डेमो हमेशा काम करता है। एक एजेंट टिकट पढ़ता है, जवाब तैयार करता है, रिफंड दर्ज करता है, और लूप बंद करता है — कमरे में सब सिर हिलाते हैं। फिर वह शिप होता है, दूसरे हज़ार मामलों से टकराता है, और उन ऑर्डरों पर रिफंड देने लगता है जो कभी हुए ही नहीं थे।
डेमो में कोई झूठ नहीं था। जो गायब था वह सब कुछ था जो दूसरे हज़ार मामलों को झेलने योग्य बनाता है — वह हिस्सा जिसे कोई फिल्म नहीं करता। स्वायत्त AI एजेंटों को शुरू करना कठिन नहीं है। उन्हें ईमानदार बनाए रखना कठिन है।
डेमो कोई सिस्टम नहीं है
एक मॉडल जो टूल कॉल कर सकता है, वह एक क्षमता है। एक सिस्टम जो सही टूल को, सही समय पर, सही स्थिति के विरुद्ध कॉल करे, और बाद में बता सके कि क्यों — वह इन्फ्रास्ट्रक्चर है। दोनों के बीच की दूरी एक बेहतर प्रॉम्प्ट से नहीं पाटी जाती।
डेमो में एजेंट एक बार चलता है, देखा जाता है, एक सुगम पथ पर। प्रोडक्शन में वह दस हज़ार बार चलता है, बिना निगरानी के, ऐसी स्थिति के विरुद्ध जो पढ़ने और कार्य करने के बीच बदल जाती है। मेमोरी पुरानी होती है या अनुपस्थित। एक दोहराया गया चरण दोहरा शुल्क लगाता है। एक टूल कॉल जिसे अस्वीकार होना चाहिए था, पास हो जाता है क्योंकि दरवाज़े पर कोई खड़ा नहीं था।
ये मॉडल की विफलताएँ नहीं हैं। ये वे विफलताएँ हैं जिन्हें एक रनटाइम को अवशोषित करना चाहिए। इन्हें प्रॉम्प्ट की समस्या मानना वह तरीका है जिससे टीमें एक तिमाही निर्देश दोबारा लिखने में बिता देती हैं और फिर भी उस एकमात्र प्रश्न का उत्तर नहीं दे पातीं जो किसी घटना की समीक्षा में मायने रखता है: एजेंट ने क्या किया, और किस आधार पर।
वह लूप जो स्वायत्त AI एजेंट वास्तव में चलाते हैं
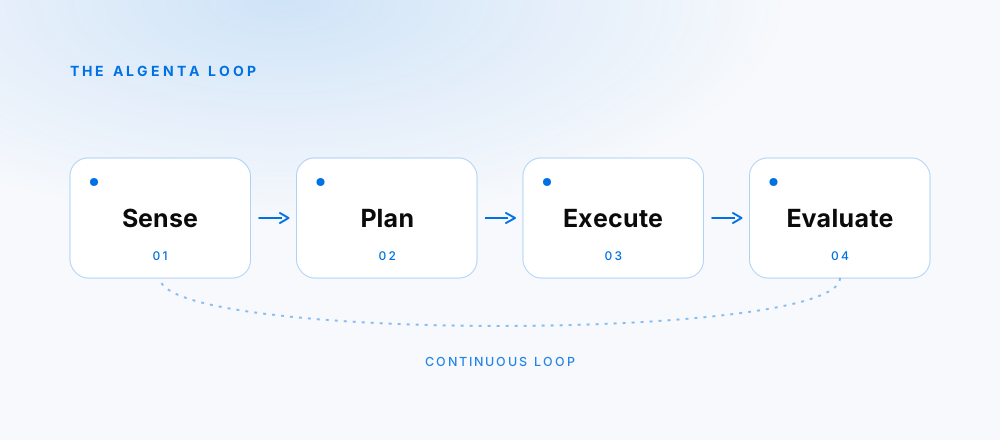
Algenta वह निर्धारक रनटाइम है जिस पर AI एजेंट कार्य करते हैं — एक ऐसे एकल लूप के इर्द-गिर्द निर्मित जिसे हर एजेंट चलाता है, चाहे उसके निर्माताओं ने उसे नाम दिया हो या नहीं। लूप को स्पष्ट करना ही अधिकांश काम है।
- Sense — दुनिया की वर्तमान स्थिति पढ़ें: इनपुट, पुनः प्राप्त मेमोरी, वे सजीव मान जिन पर निर्णय निर्भर करता है।
- Plan — उस स्थिति और लक्ष्य को देखते हुए अगला कार्य, या अगले कुछ कार्य तय करें।
- Execute — नियंत्रित टूल के माध्यम से कार्य करें, जहाँ प्रत्येक कॉल को किसी वास्तविक चीज़ को छूने से पहले पॉलिसी के विरुद्ध जाँचा जाता है।
- Evaluate — जो हुआ उसे अपेक्षाओं के विरुद्ध परखें, और वह निर्णय मेमोरी और अगली योजना में वापस डालें।
Sense, Plan, Execute, Evaluate। चरण स्पष्ट हैं; अनुशासन यह है कि अंतिम चरण को छोड़ने से इनकार किया जाए। अधिकांश एजेंट फ्रेमवर्क Execute पर रुक जाते हैं — यही कारण है कि वे डेमो में अच्छे लगते हैं और समय के साथ बिगड़ते हैं — वे कभी परखे बिना कार्य करते हैं, इसलिए त्रुटि चुपचाप बढ़ती रहती है बजाय उसी मोड़ पर पकड़े जाने के।
लूप के इर्द-गिर्द साझा आदिम तत्व हैं जिन्हें पूरा रनटाइम प्रथम श्रेणी का दर्जा देता है, न कि बाद में जोड़े गए: memory जिसे एजेंट पढ़ता और लिखता है, tools जिनके माध्यम से वह कार्य करता है, policy जो हर कार्य को नियंत्रित करती है, traces जो जो हुआ उसे दर्ज करते हैं, और evals जो तय करते हैं कि वह सही था या नहीं। लूप का प्रत्येक चरण प्रत्येक आदिम तत्व को स्पर्श करता है। Memory, Sense को पोषित करती है और Evaluate द्वारा अद्यतन होती है। Policy, Execute को नियंत्रित करती है। Traces चारों को कैप्चर करते हैं ताकि Evaluate के पास परखने के लिए कुछ ईमानदार हो।
जिस एजेंट को परखा नहीं जा सकता, वह स्वायत्त नहीं है। वह अनिगरानी में है।
साधारण आदिम तत्व ही उत्पाद क्यों हैं
Memory, policy, traces, evals। इनमें से कोई भी फोटोजेनिक नहीं है। यही सब वह है जो कमरे में काम करने वाले एजेंट को दुनिया में काम करने वाले एजेंट से अलग करता है।
Memory वह है जो एजेंट को एक पल पहले जो पता था उस पर कार्य करने देती है, न कि हर कॉल पर दुनिया को फिर से खोजने पर — और एक रनटाइम को स्थायी ज्ञान और एकल रन के कार्यक्षेत्र के बीच रेखा खींचनी होती है, क्योंकि दोनों को मिलाना वह तरीका है जिससे एजेंट अपने स्वयं के मतिभ्रम पर भरोसा करने लगता है। Policy उस टूल के बीच का अंतर है जिसे एजेंट कॉल कर सकता है और जिसे वह अभी कॉल करने की अनुमति रखता है, यह देखते हुए कि वह किसके लिए कार्य कर रहा है और इस घंटे में उसने क्या किया है। Traces "एजेंट ने कुछ अजीब किया" को एक विशिष्ट निर्णय में बदलते हैं, एक विशिष्ट इनपुट पर, उस विशिष्ट संदर्भ के साथ जो उसके पास था — डीबगिंग और अनुमान लगाने के बीच का अंतर।
Evals वह आदिम तत्व है जिसे टीमें सबसे बाद में खोजती हैं और जिसकी उन्हें सबसे पहले ज़रूरत होती है। इनके बिना, "एजेंट काम कर रहा है" का अर्थ है "अभी तक किसी ने ज़ोर से शिकायत नहीं की।" इनके साथ, हर रन को स्कोर किया जाता है — जहाँ ग्राउंड ट्रुथ मौजूद है वहाँ उसके विरुद्ध, जहाँ नहीं है वहाँ नियमों और मानदंडों के विरुद्ध — और एक रिग्रेशन एक संख्या के रूप में सामने आता है जो बदली, उस परिवर्तन पर जिसने उसे बदला, किसी ग्राहक तक पहुँचने से पहले।
ऑर्केस्ट्रेशन एक साधन है, लक्ष्य नहीं
एजेंट ऑर्केस्ट्रेशन को सबसे अधिक ध्यान मिलता है — चरणों का ग्राफ, पुनः प्रयास, एजेंटों और उप-एजेंटों के बीच हस्तांतरण। यह मायने रखता है। लेकिन बिना शासन के ऑर्केस्ट्रेशन केवल बड़े पैमाने पर गलत काम करने का तेज़ तरीका है, और बिना मूल्यांकन के ऑर्केस्ट्रेशन उसे बिना जाने करने का तेज़ तरीका है।
Algenta ऑर्केस्ट्रेशन को AI एजेंट रनटाइम वातावरण की एक परत मानता है, न कि उसका संपूर्ण। एक योजना शाखा बना सकती है, अन्य एजेंटों को कॉल कर सकती है, प्रतिबद्ध होने से पहले किसी कार्य का परीक्षण करने के लिए सिमुलेशन चला सकती है, और जब पॉलिसी माँगे तो किसी मानव की प्रतीक्षा कर सकती है — और इनमें से हर कदम उसी ट्रेस में दर्ज होता है, उसी पॉलिसी द्वारा नियंत्रित होता है, उन्हीं evals द्वारा स्कोर किया जाता है। ऑर्केस्ट्रेशन तय करता है कि आगे क्या होगा। रनटाइम तय करता है कि क्या यह अनुमत है, और क्या यह सही था।
यही AI एजेंट रनटाइम प्लेटफ़ॉर्म का मूक दावा है: कि संवेदन, योजना, कार्य और निर्णय को हर उस टीम के लिए हाथ से फिर से जोड़ा नहीं जाना चाहिए जो प्रोडक्शन में एजेंट चाहती है। ये इन्फ्रास्ट्रक्चर हैं। आपको इन्हें उसी तरह मान लेना चाहिए जैसे आप मान लेते हैं कि डेटाबेस टिकाऊ है।
जब लूप बंद होता है तो क्या बदलता है
जब पूरा लूप चलता है — जब मूल्यांकन एक बाद की सोच नहीं बल्कि हर चक्र की चौथी धड़कन है — तो काम का स्वरूप बदल जाता है। स्वायत्त AI एजेंट वह चीज़ नहीं रहते जिसे आप लॉन्च करके उम्मीद करते हैं, बल्कि वह बन जाते हैं जिसे आप संचालित कर सकते हैं: देख सकते हैं, सीमित कर सकते हैं, सुधार सकते हैं, और बताई गई सीमाओं के भीतर भरोसा कर सकते हैं।
यही डेमो और परिचालन बुद्धिमत्ता के बीच की रेखा है। डेमो आपसे विश्वास माँगता है। रनटाइम आपको जाँचने देता है। जो टीमें बड़े पैमाने पर स्वायत्त AI एजेंट चलाएँगी, वे वही हैं जो जल्दी तय कर लेती हैं कि साधारण आदिम तत्व ही उत्पाद हैं — और जिस एजेंट को परखा नहीं जा सकता, उसे बिना निगरानी के कार्य करने का अधिकार नहीं मिलता।