演示总是成功的。智能体读取工单、起草回复、处理退款、闭合流程,台下一片点头。然后它上线了,遇到了第二个一千个案例,开始为从未下过的订单办理退款。
演示里没有任何谎言。缺失的,是让第二个一千个案例得以存活的一切——那些没人拍进视频的部分。自主 AI 智能体并不难启动,难的是让它始终诚实。
演示不是系统
一个能调用工具的模型,是一种能力。一个能在正确时机、针对正确状态调用正确工具、并能事后解释原因的系统,才是基础设施。两者之间的距离,不是一个更好的提示词能填平的。
在演示中,智能体在人的注视下沿着顺畅路径运行一次。在生产环境中,它在无人监视的情况下运行一万次,面对的状态在它读取与行动之间的瞬间已悄然漂移。记忆是陈旧的,或根本不存在。一次重试导致重复扣款。一个本该被拒绝的工具调用顺利通过,因为门口没有人把守。
这些不是模型的失败,而是运行时本应吸收的失败。把它们当作提示词问题来处理,只会让团队花一个季度反复改写指令,却仍然无法回答事故复盘中唯一重要的问题:智能体做了什么,依据是什么。
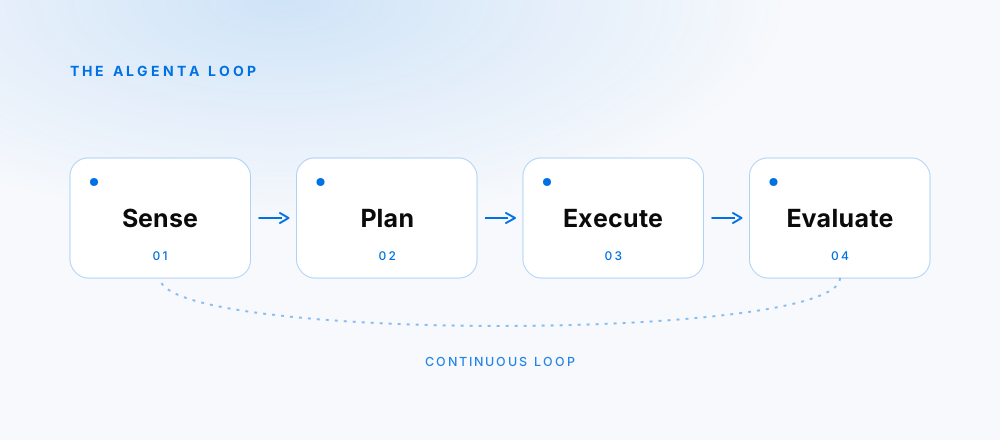
自主 AI 智能体实际运行的循环
Algenta 是 AI 智能体赖以行动的确定性运行时,围绕一个单一循环构建——无论其作者是否为其命名,每个智能体都在运行这个循环。让循环显式化,是工作的核心所在。
- 感知 — 读取世界的当前状态:输入、检索到的记忆、决策所依赖的实时值。
- 规划 — 基于当前状态与目标,决定下一步或接下来几步行动。
- 执行 — 通过受治理的工具行动,每次调用在触及任何真实事物之前都经过策略检查。
- 评估 — 对照预期判断已发生的事,并将判断结果反馈至记忆与下一轮规划。
感知、规划、执行、评估。步骤显而易见;难在于拒绝跳过最后一步。大多数智能体框架止步于执行,这正是它们演示出色、随时间劣化的原因——它们行动,却从不接受评分,于是错误在发生的那一轮未被捕获,而是悄然积累。
围绕这个循环,整个运行时将一组共享原语视为一等公民,而非附加组件:智能体读写的记忆、它借以行动的工具、约束每次行动的策略、记录所发生事件的追踪,以及判断其好坏的评估。循环的每个步骤都与每个原语相互作用。记忆为感知提供输入,并由评估更新。策略把守执行。追踪捕获全部四个步骤,使评估有真实可信的内容可供评分。
无法被评分的智能体,不是自主的,而是无人监管的。
为何那些枯燥的原语才是产品本身
记忆、策略、追踪、评估。没有一样上镜。但正是这一切,将一个在会议室里有效的智能体与一个在真实世界中有效的智能体区分开来。
记忆让智能体能够基于一秒前已知的信息行动,而不必在每次调用时重新发现世界——运行时必须划清持久知识与单次运行暂存空间之间的界限,因为混淆两者会让智能体开始信任自己的幻觉。策略区分了智能体能够调用的工具与它被允许在此刻调用的工具——取决于它代表谁行动,以及它在过去一小时内已做了什么。追踪将"智能体做了些奇怪的事"转化为一个具体决策、一个具体输入、以及它当时所拥有的具体上下文——这是调试与猜测之间的差距。
评估是团队最后发现、却最先需要的原语。没有它,"智能体运行正常"意味着"还没有人大声抱怨"。有了它,每次运行都会被评分——在有基准真相的地方对照基准真相,在没有的地方对照规则与评分标准——回归会以一个数字的形式出现,指向移动了这个数字的那次变更,在它触达用户之前。
编排是手段,而非目的
智能体编排获得了最多关注——步骤图、重试机制、智能体与子智能体之间的交接。这些确实重要。但没有治理的编排,不过是以更快的速度在规模上做错误的事;没有评估的编排,则是以更快的速度在不自知的情况下做错误的事。
Algenta 将编排视为 AI 智能体运行时环境的一个层次,而非全部。一个计划可以分支、调用其他智能体、在提交前运行模拟以测试某个行动、并在策略要求时等待人工介入——所有这些动作都落入同一条追踪,受同一套策略约束,由同一套评估评分。编排决定接下来发生什么,运行时决定它是否被允许,以及它是否正确。
这是 AI 智能体运行时平台背后那个不声张的主张:感知、规划、行动与评判,不应由每个想在生产环境中部署智能体的团队手动重新组装。它们是基础设施。你应该能够像信任数据库的持久性一样信任它们。
当循环闭合,什么会改变
当完整的循环运行起来——当评估不是事后的补充,而是每个周期的第四拍——工作的性质就会改变。自主 AI 智能体不再是你发布后寄予希望的东西,而成为你可以运营的东西:观察、约束、纠正,并在明确的边界内信任。
这就是演示与可运营智能的分界线。演示要求你相信。运行时让你得以验证。那些将在规模上运行自主 AI 智能体的团队,是那些早早决定——枯燥的原语才是产品本身,无法被评分的智能体无权在无人监管的情况下行动——的团队。